Данные объемом несколько гигабайт генерируются ежедневно. Как их сжать для хранения, чтобы они не занимали много места на диске?
Что такое сжатие данных?
Сжатие данных — это процесс использования теории информации и алгоритмов кодирования для уменьшения количества битов, необходимых для представления данных в компьютерном файле, без потери или с минимальной допустимой потерей информации.
Теоретической основой этого является информационная теория Шеннона (Shannon’s Information Theory): подавляющее большинство исходных инженерных временных рядов данных содержит значительные статистические избыточности (Redundancy) и корреляции. Суть сжатия данных заключается в устранении этой избыточности.
Обычно выделяют два основных направления:
- Сжатие без потерь (Lossless Compression): Данные после распаковки полностью идентичны исходным, полученным при сборе. Часто используется в научных вычислениях, для записи исходных данных пиков спектра оптических сенсоров и в других критически важных сценариях (распространенные алгоритмы: DEFLATE, LZ4, Zstandard, Snappy).
- Сжатие с потерями (Lossy Compression): Позволяет добиться очень высокой степени сжатия за счёт отбрасывания высокочастотного мелкомасштабного шума, незаметного для человеческого глаза или инженерного анализа. Часто используется для фильтрации мёртвых зон в аудио/видео и для стабилизации промышленных временных рядов.
Источники раздувания данных в сценариях оптической сенсорики
В системах мониторинга оптических сенсоров, таких как оптоволоконные решётки Брэгга (FBG), ежедневное создание нескольких ГБ данных обычно вызвано следующими факторами:
- Высокая частота дискретизации: Если демодулятор работает на частоте 50\ \text{Гц} или 100\ \text{Гц}, один канал генерирует от 50 до 100 кадров данных в секунду.
- Наложение точек и каналов: При использовании многоканальных систем (например, 8, 16 или 32 канала) и последовательного подключения десятков точек измерения, общее количество точек, умноженное на частоту дискретизации, приводит к генерации тысяч значений измерений с плавающей запятой в секунду.
- Неэффективный формат хранения: Многие системы по умолчанию используют текстовые форматы ASCII (например,
.csv,.txt) для хранения в открытом виде. В то время как число с двойной точностью (double) в бинарном представлении занимает всего 8 байт ( 8\ \text{Bytes} ), при хранении в виде строки (включая временные метки, запятые и символы новой строки) оно может раздуться до 20–30 байт, что приводит к многократному увеличению объёма.
Стратегии сжатия и оптимизации хранения данных объёмом несколько ГБ в день
В условиях ограниченного дискового пространства на промышленных объектах и огромных объёмов данных при длительном мониторинге рекомендуется проводить пошаговую оптимизацию по следующим четырём направлениям:
1. Использовать компактные бинарные форматы или форматы временных рядов на нижнем уровне хранения
- Отказаться от хранения в виде чистого текста CSV/TXT: Записывать данные напрямую в компактные колоночные форматы хранения (например, Parquet, HDF5, Feather) или специализированные базы данных временных рядов (например, TDengine, InfluxDB, TimescaleDB).
- Результат: Простое переключение механизма хранения с текстового на нативное бинарное представление позволяет напрямую сократить использование дискового пространства примерно на 60%–80%.
2. Применять специализированные для временных рядов алгоритмы потокового сжатия без потерь
- Сжатие разницей/XOR для чисел с плавающей запятой (алгоритмы Gorilla / Chimp): Во временных рядах промышленных данных временные метки соседних циклов дискретизации обычно имеют одинаковый интервал, а изменения длины волны или температуры/деформации при последовательных измерениях очень малы. Использование алгоритма разности (Delta-of-Delta) для сжатия временных меток в сочетании с алгоритмом XOR для сжатия мантиссы чисел с плавающей запятой позволяет добиться коэффициента сжатия от 5:1 до 10:1 при сохранении точности без потерь.
- Системное архивирующее сжатие (Zstandard / LZ4): После сохранения данных по часовым или суточным срезам использовать общие библиотеки сжатия. Zstandard (zstd) отлично сбалансирован по скорости сжатия и степени сжатия.
3. Применять на уровне алгоритмов сжатие с потерями / фильтрацию мёртвых зон (Swinging Door Trending / Deadband)
- Алгоритм Swinging Door (SDT) или фильтрация мёртвых зон по порогу: Установить диапазон допуска (например, смещение длины волны \Delta\lambda \le 1\ \text{pm} или изменение температуры \Delta T \le 0.1\ ^\circ\text{C} считаются шумом в установившемся режиме). В фазе установившегося режима, когда объект мониторинга не испытывает резких колебаний, записывать только точки излома тренда, игнорируя избыточные точки на прямых участках.
- Регистрация по событию (Event-triggered Logging): Для вибраций, ударов или резких аномальных изменений система обычно использует низкочастотную запись или кольцевой буфер памяти с циклическим перезаписыванием; только при фиксации превышения порога или высокочастотного переходного события полные исходные данные во всем диапазоне частот сохраняются на диск.
4. Разумно конфигурировать частоту дискретизации приборов у источника
Для мониторинга медленных изменений, таких как квазистатическая деформация мостов, оседание оснований резервуаров или фоновое изменение температуры окружающей среды, нет необходимости длительное время поддерживать сверхвысокую частоту дискретизации. Например, OFSCN® Fiber Bragg Grating Interrogator от Beijing Dacheng Yongsheng Technology Co., Ltd. (大成永盛) имеет встроенное программное обеспечение, которое позволяет снизить частоту дискретизации с стандартных 100\ \text{Гц} или 50\ \text{Гц} до 1\ \text{Гц} или даже ниже, в соответствии с фактическими потребностями проекта:
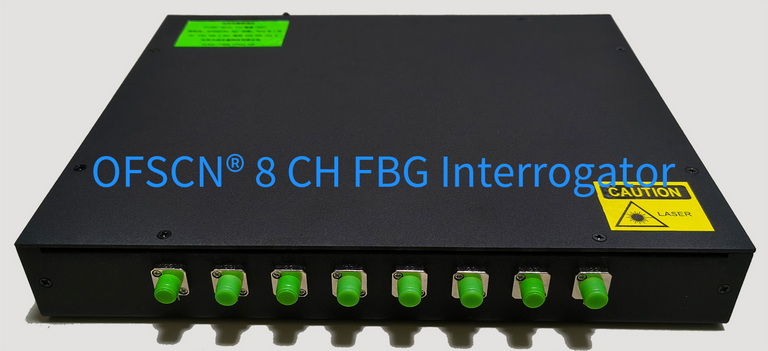
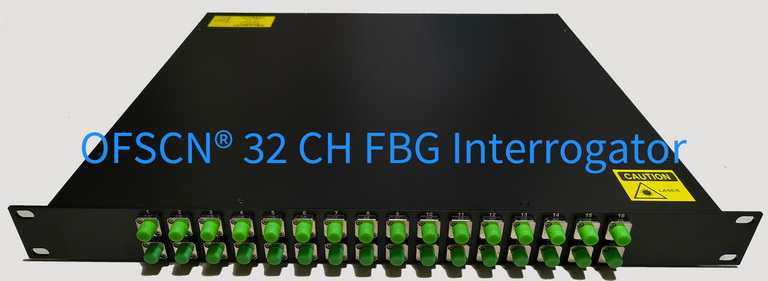
Если снизить частоту дискретизации со 100\ \text{Гц} до 1\ \text{Гц}, это позволит сократить объём генерируемых исходных данных на 99% уже на этапе источника.
Резюме по плану реализации
- Краткосрочный эффект: Прекратить запись в CSV, перейти на SQLite/HDF5/Parquet или интегрировать алгоритм
zstdв программное обеспечение для сжатия данных в процессе сбора. - Среднесрочная системная оптимизация: Установить разумную частоту дискретизации оборудования в зависимости от свойств измеряемой физической величины (динамическая усталость vs статическая температура) и добавить фильтрацию мёртвых зон.
- Долгосрочная эволюция архитектуры: Внедрить движок хранения промышленных временных рядов, реализовать многоуровневую стратегию хранения: «краткосрочное хранение и перезапись высокочастотных данных, долгосрочное архивирование низкочастотных / характерных трендовых данных».