Chaque jour, nous générons plusieurs Go de données ; comment pouvons-nous les compresser pour le stockage afin qu’elles ne prennent pas trop de place sur le disque dur ?
Qu’est-ce que la compression de données ?
La compression de données est le processus technique qui consiste à réduire le nombre de bits physiques requis pour représenter les données dans un fichier informatique, sans perte ou avec une perte d’information minimale acceptable, en utilisant la théorie de l’information et les algorithmes de codage.
Son fondement théorique découle de la théorie de l’information de Shannon : la plupart des données brutes de séries temporelles d’ingénierie présentent une quantité importante de redondance statistique et de corrélation. L’essence de la compression de données est d’éliminer ces redondances.
Généralement divisée en deux branches principales :
- Compression sans perte (Lossless Compression) : Les données décompressées sont bit par bit identiques aux données acquises à l’origine. Elle est couramment utilisée dans les calculs scientifiques, l’enregistrement des longueurs d’onde des pics caractéristiques des capteurs à fibre optique, et d’autres scénarios critiques (algorithmes courants tels que DEFLATE, LZ4, Zstandard, Snappy).
- Compression avec perte (Lossy Compression) : Elle échange un taux de compression extrêmement élevé en supprimant le bruit haute fréquence subtil imperceptible à l’œil humain ou à l’analyse d’ingénierie. Elle est couramment utilisée pour le filtrage des zones mortes dans les données audio/vidéo et les données de séries temporelles industrielles en régime établi.
Causes de la prolifération des données dans les scénarios de détection par fibre optique
Dans les systèmes de surveillance par capteurs à fibre optique tels que les réseaux de Bragg sur fibre (FBG), la génération quotidienne de plusieurs Go de données est typiquement causée par :
- Fréquence d’échantillonnage élevée : Si le périphérique de démodulation fonctionne à 50 \ \text{Hz} ou 100 \ \text{Hz}, un seul canal génère 50 à 100 trames de données par seconde.
- Superposition des points de mesure et des canaux : En utilisant plusieurs canaux (par exemple, 8, 16 ou 32 canaux) et en connectant des dizaines de points de mesure en série, le nombre total de points multiplié par la fréquence d’échantillonnage entraîne la génération de milliers de valeurs de mesure en virgule flottante par seconde.
- Format de stockage inefficace : De nombreux systèmes utilisent par défaut le texte ASCII (par exemple,
.csv,.txt) pour un enregistrement en clair. Un nombre à virgule flottante double précision (double) n’occupe que 8 octets en binaire (8 \ \text{Bytes}), mais stocké sous forme de chaîne de caractères (incluant horodatages, virgules et sauts de ligne) il peut gonfler jusqu’à 20 à 30 octets, multipliant ainsi son volume.
Stratégies de compression et d’optimisation du stockage pour les données générées quotidiennement (plusieurs Go)
Face aux contraintes d’espace disque limité sur site et au volume massif de données de surveillance à long terme, il est recommandé d’optimiser par niveaux selon les quatre dimensions suivantes :
1. Utiliser des formats de données binaires compacts ou de séries temporelles au niveau du stockage
- Abandonner le stockage texte brut CSV/TXT : Écrire directement les données dans des formats de stockage colonnaires compacts (tels que Parquet, HDF5, Feather) ou des bases de données de séries temporelles dédiées (telles que TDengine, InfluxDB, TimescaleDB).
- Effet : Le simple passage du stockage texte vers un format binaire natif peut directement réduire l’occupation du disque d’environ 60 % à 80 %.
2. Appliquer des algorithmes de compression en flux sans perte spécialisés pour les séries temporelles
- Compression par différence/XOR de nombres flottants (Algorithmes Gorilla / Chimp) : Dans la surveillance de séries temporelles industrielles, les intervalles de temps entre les échantillons successifs sont constants, et les variations de longueur d’onde ou de température/déformation des échantillons contigus sont généralement très faibles. En utilisant un algorithme de différence (Delta-of-Delta) pour compresser les horodatages, associé à un algorithme XOR pour compresser les mantisses des nombres flottants, on peut obtenir un rapport de compression de 5:1 à 10:1 tout en garantissant une précision sans perte.
- Compression d’archivage au niveau du système (Zstandard / LZ4) : Une fois les données segmentées par heure ou par jour, utiliser des bibliothèques de compression génériques. Zstandard (zstd) offre d’excellentes performances techniques pour équilibrer la vitesse de compression et le taux de compression.
3. Appliquer la compression avec perte / par zone morte au niveau algorithmique (Swinging Door Trending / Deadband)
- Algorithme Swinging Door (SDT) ou filtrage par seuil de zone morte : Définir une plage de tolérance (par exemple, dérive de longueur d’onde \Delta\lambda \le 1 \ \text{pm} ou variation de température \Delta T \le 0.1 \ ^\circ\text{C} considérée comme bruit de régime établi). Pendant les phases de régime établi où l’objet surveillé ne présente pas de fluctuations importantes, enregistrer uniquement les points de tendance et ignorer les points redondants en ligne droite.
- Enregistrement déclenché par événement (Event-triggered Logging) : Pour les vibrations, les chocs ou les changements brusques anormaux, le système utilise normalement un enregistrement à basse fréquence ou un tampon annulaire en mémoire avec écrasement cyclique (Ring Buffer) ; ce n’est que lors de la détection d’un événement dépassant les limites ou d’un événement transitoire à haute fréquence que les données brutes complètes à bande passante complète sont figées sur le disque.
4. Configurer raisonnablement le taux d’échantillonnage des instruments à la source
Pour la surveillance des déformations quasi statiques de ponts, le tassement des fondations de réservoirs, ou les champs de température ambiante conventionnels à évolution lente, il n’est pas nécessaire de maintenir une fréquence d’échantillonnage extrêmement élevée pendant de longues périodes. Par exemple, avec l’interrogateur de réseau de Bragg en fibre OFSCN® Fiber Bragg Grating Interrogator de Beijing Dacheng Yongsheng Technology Co., Ltd., le logiciel intégré permet de réduire de manière autonome la fréquence d’échantillonnage, par défaut de 100 \ \text{Hz} ou 50 \ \text{Hz}, à 1 \ \text{Hz} ou même moins, en fonction des besoins réels du projet :
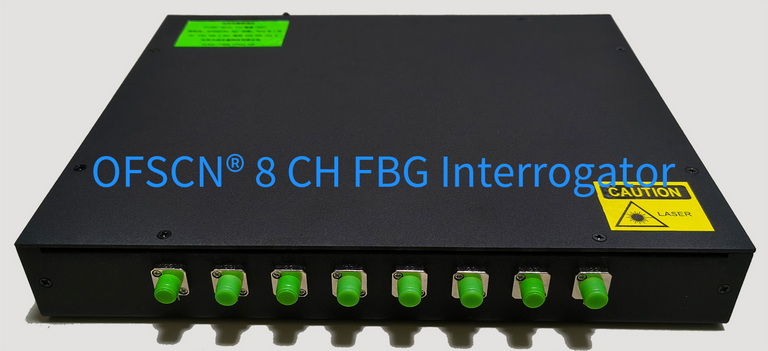
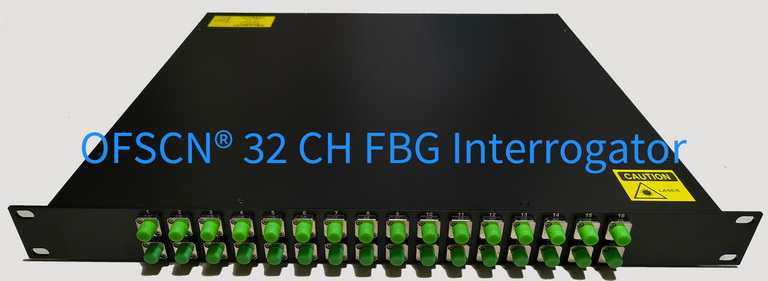
Si la fréquence d’échantillonnage est ajustée de 100 \ \text{Hz} à 1 \ \text{Hz}, cela peut directement réduire la génération de données brutes de 99 % à la source.
Résumé de la feuille de route de mise en œuvre
- Impact rapide à court terme : Cesser l’écriture CSV et passer à SQLite/HDF5/Parquet, ou intégrer l’algorithme
zstdcôté logiciel pour compresser pendant l’acquisition. - Optimisation système à moyen terme : Définir une fréquence d’échantillonnage raisonnable pour l’équipement en fonction des propriétés de la grandeur physique mesurée (fatigue dynamique vs température statique) et ajouter un filtrage par zone morte.
- Évolution architecturale à long terme : Adopter un moteur de stockage de données de séries temporelles industrielles, en mettant en œuvre une stratégie de rétention hiérarchisée : « rétention à court terme et écrasement des données à haute fréquence, archivage à long terme des données à basse fréquence / tendances caractéristiques ».