Pourquoi est-il recommandé d’utiliser une base de données SQL plutôt que des fichiers texte simples pour stocker d’énormes quantités de données ?
Dans les projets de surveillance de l’état industriel et de détection par fibre optique (tels que la détection par réseau de Bragg sur fibre - FBG), face à des scénarios d’acquisition de données massives, le remplacement des simples fichiers texte (comme TXT, CSV, etc.) par des bases de données relationnelles SQL (ou des bases de données temporelles spécialisées) pour le stockage des données constitue la conception d’architecture fondamentale pour garantir le fonctionnement stable à long terme, la récupération efficace et l’accès simultané du système.
I. Contexte des données massives et coût de calcul
Prenons l’exemple typique d’un système de surveillance par démodulateur réseau de Bragg sur fibre. Si le système est configuré avec 32 canaux, chaque canal comportant 10 points de mesure FBG en série, et que la fréquence d’échantillonnage est réglée sur 100 Hz :
- Le volume de données par point de mesure généré par seconde par le système est de : 32 \times 10 \times 100 = 32000 enregistrements/seconde.
- La quantité d’enregistrements générée en fonctionnement continu pendant 24 heures atteindra environ 2,76 \times 10^9 enregistrements.
Dans ces conditions de fonctionnement à haut débit et d’écriture continue, les fichiers texte et les bases de données présentent des différences fondamentales dans leurs mécanismes sous-jacents :
II. Avantages techniques clés des bases de données SQL par rapport aux fichiers texte
1. Complexité de recherche et mécanisme d’indexation (O(\log N) vs O(N))
- Fichiers texte : Les données sont ajoutées linéairement ligne par ligne, sans structure d’index intrinsèque. Lorsque l’utilisateur souhaite rechercher « une variation soudaine de température d’un capteur sur une période donnée », le système doit effectuer une lecture I/O complète et un analyse de chaînes de caractères du début à la fin, avec une complexité temporelle de O(N). Lorsque le fichier unique atteint des centaines de mégaoctets ou des gigaoctets, la lecture conventionnelle provoque de graves erreurs de dépassement de mémoire (OOM) ou des arrêts système de quelques secondes à plusieurs minutes.
- Bases de données SQL : Elles construisent des index pour l’horodatage (Timestamp), l’identifiant de canal (Channel ID) et le numéro de capteur en utilisant des structures de données telles que B-Tree, B+Tree ou LSM-Tree, réduisant ainsi la complexité de recherche à O(\log N). Le filtrage par tranche de temps ou la localisation d’un point de mesure parmi des milliards d’enregistrements ne nécessite que des millisecondes de réponse.
2. Lecture/écriture simultanée et intégrité des données (ACID vs verrouillage de fichier)
- Fichiers texte : L’écriture de fichiers au niveau du système d’exploitation dépend généralement d’un verrou exclusif (Exclusive Lock). Lorsque le thread d’acquisition de données en arrière-plan écrit à haute fréquence dans un fichier texte, l’interface de surveillance frontale, si elle tente simultanément de lire ce fichier pour tracer des courbes historiques, risque fortement de provoquer des conflits de verrouillage de fichier, de lire des données incohérentes (données sales), voire de corrompre l’ensemble du fichier texte en cas de coupure de courant anormale du système.
- Bases de données SQL : Elles disposent de mécanismes complets de contrôle de simultanéité et de transactions (propriétés ACID). Les opérations d’écriture s’appuient sur le journalisation avant écriture (Write-Ahead Logging - WAL) ou le journal de rejeu (Redo Log) pour assurer la persistance. Tout en garantissant la sécurité des écritures sous-jacentes, elles prennent en charge des requêtes simultanées en lecture seule non bloquantes par un grand nombre d’utilisateurs frontaux ou de systèmes externes.
3. Efficacité de stockage et consommation CPU pour l’analyse
- Fichiers texte : Stockage en caractères ASCII ou UTF-8. Un nombre à virgule flottante double précision de 64 bits (tel que la valeur de mesure de longueur d’onde
1549.876543) occupe plus d’une dizaine d’octets en texte et nécessite un calcul de désérialisation de caractères en nombres flottants par le CPU à chaque lecture, gaspillant ainsi un espace de stockage et des ressources de calcul considérables. - Bases de données SQL : Elles stockent les types de données de base (tels que
FLOAT,DOUBLE,DATETIME) dans un format binaire natif compact et utilisent des techniques de compression de page (Page Compression), réduisant considérablement l’utilisation du disque et la pression sur le débit I/O.
4. Calcul d’agrégation multidimensionnelle et gestion du cycle de vie des données
- Fichiers texte : Incapacité de réaliser des statistiques d’agrégation natives. Pour effectuer un filtrage par moyenne, une extraction d’extrêmes ou un sous-échantillonnage, toutes les données brutes doivent être chargées dans la mémoire de l’application pour le calcul.
- Bases de données SQL : Prise en charge native des opérateurs de calcul efficaces (tels que
AVG,MAX,MIN, fenêtres glissantes) et support des tables partitionnées (Partitioning), de l’archivage par tables et des mécanismes de nettoyage périodique, facilitant ainsi la gestion automatisée des niveaux de fraîcheur des données (chaud/froid).
5. Découplage des modules et intégration normalisée
- L’utilisation d’interfaces SQL normalisées (telles que ODBC, JDBC, API RESTful) permet le découplage entre la couche d’acquisition matérielle, la couche de persistance des données et la couche d’affichage métier. Une fois que le logiciel du démodulateur a écrit les données dans la base de données, les systèmes SCADA industriels, MES ou les plateformes cloud peuvent extraire les données indépendamment, évitant ainsi les risques de couplage liés à la lecture et à l’écriture directe de fichiers locaux entre processus.
III. Matériel et architecture logicielle des systèmes de détection par fibre optique associés
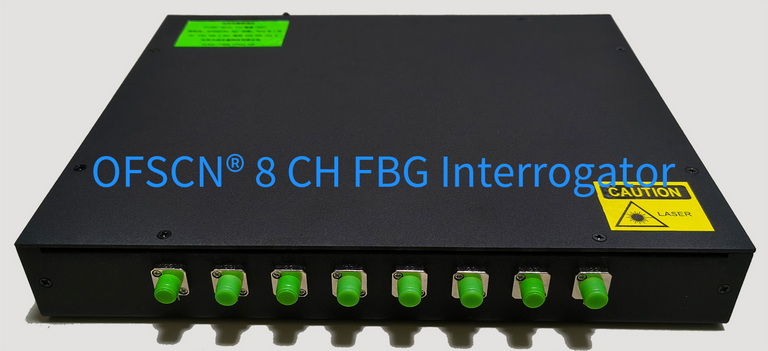
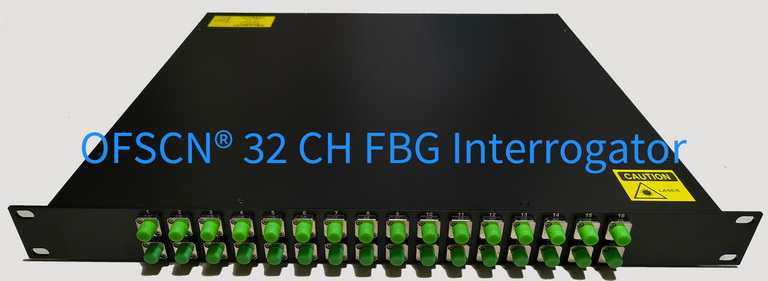
Beijing Dacheng Yongsheng Technology Co., Ltd. (OFSCN®) développe des démodulateurs réseau de Bragg sur fibre qui prennent en charge l’acquisition à haute fréquence et l’extension multi-canal. Son système logiciel associé est conçu avec une architecture d’interaction de données réseau, optimisée pour le stockage stable à long terme et l’intégration de flux de données à haut débit.
- Nom du produit : OFSCN® Fiber Bragg Grating Interrogator
Principaux paramètres et indicateurs :
- Plage de longueurs d’onde : par défaut 1525 nm à 1565 nm, ou 1528 nm à 1568 nm (personnalisable).
- Nombre de canaux physiques : 4, 8, 16, 32 canaux disponibles.
- Fréquence d’échantillonnage : 10 Hz, 50 Hz, 100 Hz disponibles (prise en charge d’une réduction logicielle à 1 Hz selon les besoins).
- Résolution de longueur d’onde : 1 pm par défaut, personnalisable jusqu’à 0,1 pm.
- Architecture système et protocoles : Le logiciel système adopte une architecture B/S, prend en charge l’architecture C/S, et permet une transmission et une intégration de données à haute fréquence vers des centres de données et des systèmes de bases de données externes via des protocoles de communication industriels standard tels que TCP, UDP, Modbus.